De l’application mobile à la session PDU : comprendre la connectivité et la QoS en 5G

1. Introduction : que se passe-t-il lorsque nous ouvrons une application ?

Lorsqu’un utilisateur installe une application depuis un store, il ne se préoccupe généralement pas de la manière dont son smartphone communiquera avec les serveurs de l’application. Pourtant, plusieurs mécanismes interviennent :

  1. sélection du réseau de données,
  2. établissement éventuel d’une session PDU,
  3. identification des flux applicatifs et application des règles de qualité de service.

En 5G, ces opérations sont dissociées. Une application n’a pas nécessairement besoin de sa propre session PDU, et une même session peut transporter plusieurs flux bénéficiant de traitements QoS différents.
Cette possibilité de différencier les traitements QoS existait déjà en 4G, où une connexion PDN pouvait comporter plusieurs EPS bearers. La principale évolution introduite par la 5G réside dans une séparation plus souple entre la connectivité, les flux QoS et les ressources de transport. Les QoS flows constituent désormais l’unité de différenciation QoS et peuvent être associés aux ressources radio indépendamment de leur identification au sein de la session PDU (En 4G, chaque EPS bearer est associé à un E-RAB lorsqu’il est établi sur l’accès LTE. En 5G, plusieurs QoS flows peuvent être associés à un même DRB et partager un tunnel N3).

Prenons le cas d’une application de télémédecine. Elle peut transporter de la vidéo, de l’audio et des données médicales. Ces trois types de trafic n’ont pas nécessairement les mêmes exigences : l’audio est sensible au délai, la vidéo nécessite un débit suffisant et le transfert d’un document peut généralement tolérer davantage de latence.

Une session PDU, plusieurs traitements QoS

Exemple sur l’application de télémédecine : Audio · Vidéo · Documents

Cet exemple illustre une possibilité du modèle 5G, et non un comportement automatique. Un opérateur peut parfaitement transporter ces trois trafics dans un seul flux QoS lorsque leurs exigences et sa politique le permettent.

2. De l’installation de l’application au choix de la session

2.1. Que se passe-t-il lors du téléchargement d’une application ?

Le téléchargement depuis un store utilise une session PDU donnant accès à Internet ou une connexion Wi-Fi déjà disponible.

Lorsque l’application s’installe, l’OS du terminal récupère l’identifiant de l’application.Pour l’application de télémédecine, on suppose l’identifiant de package : com.hopital.telemedecine. Celui-ci permet d’identifier l’application dans un store.

Toutefois, cet identifiant Android ne doit pas être confondu avec l’identifiant applicatif utilisé dans les politiques de routage définies par la 3GPP.

La 3GPP définit le couple OSId/OSAppId

  • OSId identifie le système d’exploitation selon un format UUID de 128 bits.
  • OSAppId identifie une application ou une catégorie reconnue par l’OS

La 3GPP laisse au système d’exploitation le soin de définir la signification des OSAppId. Un OSAppId peut désigner une application particulière, mais aussi une catégorie d’applications. L’OSAppID n’est pas obligatoirement attribuée à chaque application.

La correspondance entre l’identifiant de package Android et l’OSAppId dépend de l’implémentation du système d’exploitation. L’installation d’une application ne garantit donc pas qu’elle possède un OSAppId exploitable par les règles URSP.

Par exemple, dans une implémentation Android prenant en charge le découpage réseau, la catégorie ENTERPRISE va permettre d’identifier certains trafics professionnels. Plusieurs applications peuvent donc être associées au même OSAppId si elles le demandent et que l’OS l’y autorise ou si la MDM (Mobile Device Management) l’a placée dans un profil professionnel.

Cette identification peut ensuite être utilisée par les règles URSP pour sélectionner une session PDU adaptée au trafic applicatif, lorsque le terminal prend en charge ce mécanisme.

Figure 2 : Installation d’une application et ses identifiants

2.2 L’installation d’une application ne crée pas nécessairement une session

L’installation de l’application ne provoque pas, à elle seule, la création d’une session PDU spécifique. C’est lorsque l’application commence à utiliser le réseau que le terminal doit déterminer comment acheminer son trafic.

Il faut distinguer deux décisions :

  • La sélection de la route : quelle session PDU doit transporter le trafic ?
  • La classification QoS : quel traitement les paquets doivent-ils recevoir à l’intérieur de cette session ?

Ces décisions relèvent de mécanismes différents.

2.3. Les règles URSP – UE Route Selection Policy : sélectionner la route du trafic applicatif

Les UE Route Selection Policy (URSP), définies dans la TS 23.503, permettent de définir des politiques de routage applicatif dans le terminal.

Une règle URSP comprend un Traffic Descriptor, qui permet d’identifier le trafic concerné, et un ou plusieurs Route Selection Descriptors (RSD), qui décrivent les caractéristiques de la route recherchée.

Le Traffic Descriptor peut exploiter :

  • un identifiant applicatif reconnu par le terminal (exemple com.hopital.telemedecine)
  • des informations de destination IP, exemple l’adresse du serveur mail
  • un domaine ou une capacité de connexion.

Le Route Selection Descriptor (RSD) définit les caractéristiques de la session PDU recherchée. Il peut notamment préciser :

  • le DNN, qui identifie le réseau de données ;
  • le S-NSSAI, qui identifie la tranche réseau ;
  • le type de session PDU (IPv4, IPv6, IPv4v6, Ethernet ou Unstructured) ;
  • le mode SSC, qui définit les modalités de continuité de la session ;
  • les préférences d’accès (3GPP, non-3GPP ou multi-accès).

Le terminal recherche alors une session PDU existante compatible avec le RSD retenu. S’il en trouve une, il peut la réutiliser ; sinon, il peut tenter d’en établir une nouvelle.

Figure 3 : Correspondance entre application et les règles de trafic

Si un paramètre n’est pas précisé dans le RSD, la session va s’établir avec les informations de configuration ou des valeurs par défaut du terminal.

L’opérateur fournit les règles URSP au terminal selon l’une des 3 manières suivantes :

  1. Par le PCF : les règles sont transmises dynamiquement au terminal par la signalisation du réseau 5G, via l’AMF.
  2. Par l’USIM : les règles sont préconfigurées dans la carte SIM de l’opérateur.
  3. Par le terminal (ME, Mobile Equipment) : les règles sont préconfigurées dans le terminal, par exemple au moyen d’une configuration logicielle de l’opérateur.

Ces trois méthodes ne sont pas équivalentes. La 3GPP définit l’ordre de priorité indiqué par la numérotation ci-dessus :

  1. Règles fournies par le PCF prévalent sur les règles préconfigurées.
  2. Règles préconfigurées dans l’USIM sont utilisées en l’absence de règles fournies par le PCF
  3. Règles préconfigurées dans le terminal (ME) sont utilisées lorsqu’aucune des deux sources précédentes ne fournit de règles applicables.

Leur application effective dépend également des capacités du terminal et de son système d’exploitation. Il ne faut donc pas supposer que toute application téléchargée possède un identifiant exploitable par l’URSP ou qu’elle bénéficie automatiquement d’une tranche dédiée.

2.4. DNN et S-NSSAI : deux informations complémentaires

Le DNN (Data Network Name) désigne le réseau de données auquel le terminal souhaite accéder. Le S-NSSAI (Single Network Slice Selection Assistance Information) identifie une tranche de réseau.

Le couple DNN/S-NSSAI contribue à déterminer les fonctions de réseau et les politiques applicables à la session. Il ne constitue toutefois pas, à lui seul, un identifiant unique de session : un terminal peut établir plusieurs sessions PDU vers un même DNN et un même S-NSSAI.

On rappelle que le couple DNN/S-NSSAI constitue un critère central de découverte et de sélection du SMF, mais il ne suffit généralement pas à identifier une instance SMF unique. L’AMF peut s’appuyer sur le NRF pour découvrir les SMF compatibles, puis tenir compte d’autres paramètres, la localisation du terminal, les données d’abonnement, les capacités et la charge des SMF ainsi que les politiques de l’opérateur. Plusieurs sessions PDU peuvent partager le même DNN et le même S-NSSAI, tout en étant distinguées par leurs PDU Session ID

La session est identifiée, du point de vue du terminal, par son PDU Session ID.

3. Comment le réseau établit-il la session PDU ?

Considérons maintenant le cas où aucune session existante ne répond aux critères de routage.

La procédure décrite ici est celle d’un établissement demandé par le terminal, en situation non itinérante, conformément à la TS 23.502, section 4.3.2.2.1.

Les grandes étapes de l’établissement

  1. Le terminal demande la session.

    Le UE transmet à l’AMF un message NAS contenant le PDU Session ID, le DNN et le S-NSSAI demandés lorsqu’ils sont fournis, ainsi qu’un conteneur N1 SM comprenant le PDU Session Establishment Request.

  2. L’AMF sélectionne le SMF.

    Il s’appuie sur les informations d’abonnement, le DNN, le S-NSSAI, la localisation et la découverte des fonctions réseau. Le NSSF peut contribuer à la sélection du contexte de tranche ; le NRF permet de découvrir des SMF compatibles.

  3. Le SMF vérifie et prépare la session.

    Il vérifie les données d’abonnement auprès de l’UDM, détermine les politiques applicables, éventuellement avec le PCF, sélectionne le ou les UPF et prépare l’adressage IP si la session est de type IP.

  4. Le SMF configure le plan usager.

    Par N4/PFCP, il installe dans le ou les UPF les règles nécessaires à la détection, à l’acheminement, à la QoS et éventuellement à la mesure du trafic.

  5. Le réseau configure l’accès radio et informe le terminal.

    Le SMF fournit les informations N2 destinées au gNB et le message N1 SM PDU Session Establishment Accept destiné au terminal. Le gNB configure les ressources radio nécessaires et retourne les informations de tunnel permettant de finaliser le chemin descendant.

À l’issue de cette procédure, le terminal dispose d’une session PDU avec au moins un QoS flow associé à la règle QoS par défaut. Il peut alors transmettre le trafic correspondant à cette session.

La session PDU n’est pas nécessairement établie à chaque ouverture d’application. Elle peut rester disponible et être réutilisée par plusieurs applications.

4. Comment la QoS est-elle attribuée aux flux ?

L’établissement de la session et l’attribution de la QoS sont deux opérations conceptuellement distinctes, même si elles peuvent intervenir au cours de la même procédure.

4.1. Du besoin applicatif aux règles PCC

Le PCF (Policy Control Function) peut fournir au SMF des règles PCC (Policy and Charging Control). Elles permettent de caractériser des flux de service, de définir leur traitement QoS et de préciser les conditions de tarification applicables.

Le SMF traduit ces règles en instructions destinées aux différentes entités du réseau.

Destinataire Informations et rôle
UE QoS rules pour classifier les paquets montants
UPF Règles PDR, FAR, QER et éventuellement URR
gNB QFI et profils QoS permettant de traiter les flux sur l’accès radio

Le SMF réalise l’association des règles PCC aux flux QoS . Plusieurs règles PCC peuvent être associées à un même flux QoS lorsqu’elles sont compatibles.

4.2. Ne pas confondre QFI et 5QI

Le QFI identifie un flux QoS à l’intérieur d’une session PDU. Le 5QI caractérise le traitement QoS attendu, à travers des paramètres tels que la priorité, le délai et le taux d’erreur des paquets.

Deux flux QoS différents peuvent donc avoir le même 5QI. Inversement, un QFI n’est pas une mesure de priorité : le QFI 1 n’est pas intrinsèquement prioritaire sur le QFI 2.

Un flux QoS peut être non-GBR, sans débit garanti, ou GBR, avec des paramètres de débit garanti et maximal. Le profil QoS transmis au réseau d’accès contient le 5QI et l’ARP, ainsi que les paramètres de débit requis pour les flux GBR.

4.3. Le rôle des règles QoS dans le terminal

Une règle QoS permet au terminal de décider à quel flux QoS associer un paquet montant. Elle comporte un ensemble de filtres de paquets, une précédence et le QFI du flux correspondant.

La règle QoS par défaut permet de traiter le trafic qui ne correspond à aucune règle plus spécifique.

Dans notre exemple de télémédecine, le terminal pourrait ainsi disposer d’une règle spécifique pour le trafic audio et utiliser la règle par défaut pour les documents. Les filtres peuvent exploiter des informations telles que les adresses IP, les ports et les protocoles.

Les règles URSP et les règles QoS remplissent deux fonctions complémentaires. Les premières permettent au terminal de sélectionner une session PDU adaptée au trafic applicatif, notamment à partir du DNN et du S-NSSAI. Une fois cette session sélectionnée, les règles QoS permettent de classifier les paquets montants et de les associer aux QoS flows appropriés. Une même session PDU peut ainsi transporter plusieurs flux applicatifs bénéficiant de traitements QoS différents, sans nécessiter l’établissement d’une session distincte pour chacun d’eux

5. Réutiliser une session PDU : où se situe le gain de signalisation ?

C’est une évolution architecturale du modèle 5G : Imaginons qu’un utilisateur dispose déjà d’une session PDU pour accéder à Internet. Il ouvre ensuite une application de visioconférence. Trois situations sont possibles.

Situation A : Le trafic utilise un flux QoS existant

L’application utilise la session PDU déjà établie. Les paquets correspondent à une règle QoS existante, éventuellement la règle par défaut. Aucune nouvelle signalisation de session ou de QoS nécessaire

Situation B : Une nouvelle règle est nécessaire, sans nouveau flux QoS 

Le réseau souhaite classifier plus précisément le trafic, mais le traitement QoS requis est compatible avec un flux déjà établi. Le SMF peut mettre à jour les règles de classification au niveau du terminal et de l’UPF, tout en conservant le même QFI. Cette classification peut être l’adresse IP du serveur. Il peut y avoir un échange de Signalisation, sans nouvelle session ni nouveau QoS flow

Situation C : Un nouveau flux QoS est nécessaire

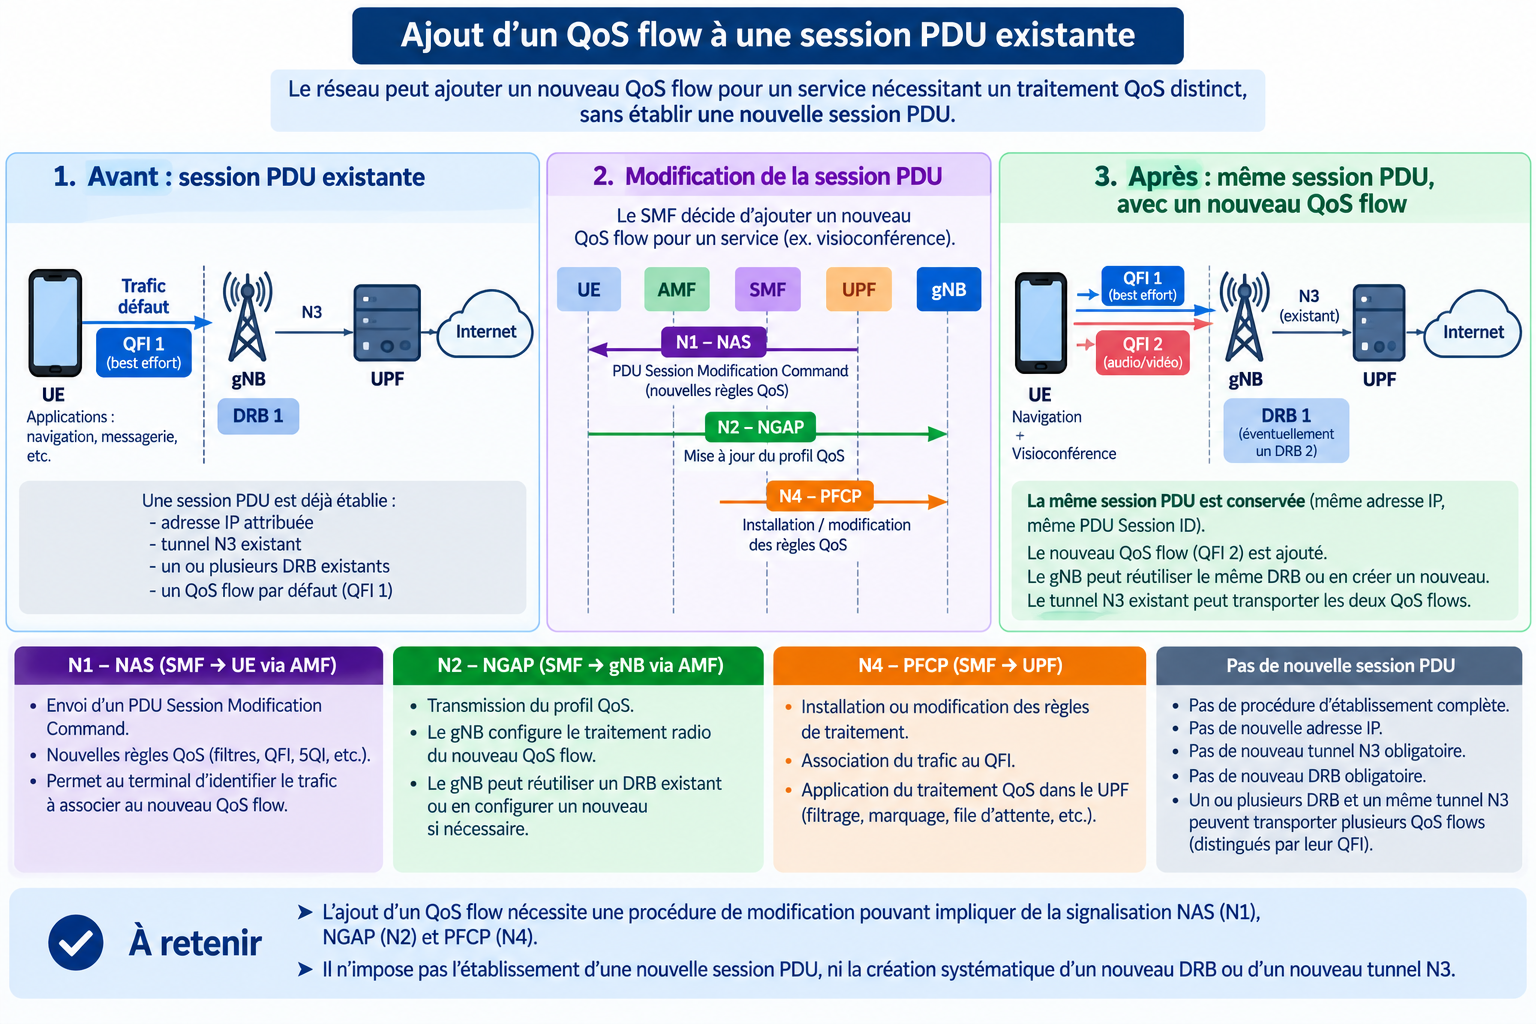
Le service nécessite un traitement QoS distinct. Le SMF peut ajouter un flux QoS à la session existante, configurer les règles correspondantes et, lorsque nécessaire, transmettre son profil QoS au gNB.

* Selon les règles déjà présentes, une mise à jour du terminal peut être nécessaire.
** Dans le scénario considéré, sans ajout d’un chemin de transport particulier.
L’ajout d’un flux QoS à une session PDU existante peut nécessiter une procédure de modification comprenant de la signalisation NAS (N1), NGAP (N2) et PFCP (N4). Il n’impose cependant ni l’établissement d’une nouvelle session PDU, ni la création systématique d’un nouveau DRB ou d’un nouveau tunnel N3.

La procédure de modification d’une session PDU est définie dans la TS 23.502, section 4.3.3. Le contrôle des QoS flows et les possibilités de préconfiguration sont décrits dans la TS 23.501, section 5.7.


5.1. Pourquoi un nouveau QoS flow ne nécessite-t-il pas forcément un nouveau DRB ?

Dans le réseau d’accès 5G, la couche SDAP assure l’association des flux QoS aux Data Radio Bearers (DRB). Le gNB peut transporter plusieurs flux QoS sur un même DRB si leurs exigences le permettent.

Ainsi, l’ajout d’un nouveau flux QoS ne signifie pas nécessairement la création d’un nouveau bearer radio. Il peut néanmoins nécessiter une mise à jour des informations QoS et de la configuration radio.

Il faut également distinguer le tunnel N3 de la session et les différents QoS flows qu’il transporte. Plusieurs QFI peuvent être multiplexés dans le tunnel N3 d’une même session, sans création d’un tunnel par QFI. Des architectures comportant plusieurs chemins ou tunnels constituent des cas particuliers.

Une modification QoS peut toujours nécessiter plusieurs échanges entre le SMF, l’UPF, le gNB et le terminal

5.2. La Reflective QoS : apprendre à partir du trafic descendant

5.2. La Reflective QoS : déduire les règles montantes du trafic descendant

La Reflective QoS permet au terminal de déduire certaines règles de classification du trafic montant à partir des paquets reçus en liaison descendante. Elle peut ainsi limiter la nécessité de transmettre explicitement de nouvelles règles QoS au terminal.

Prenons l’exemple de notre application de visioconférence. Le réseau a établi un flux QoS particulier pour le trafic vidéo. Lorsque le mécanisme de Reflective QoS est activé, le réseau peut indiquer au terminal, au moyen du Reflective QoS Indicator (RQI), qu’il doit appliquer ce mécanisme aux paquets descendants concernés.

À la réception de ces paquets, le terminal peut créer une règle QoS dérivée, en utilisant notamment les informations d’en-tête des paquets et leur QFI. Les paquets montants correspondant à cette règle sont alors associés au même QFI.

Contrairement à une règle QoS explicitement signalée au terminal, cette règle est déduite du trafic descendant et possède une durée de validité contrôlée par un temporisateur.

Ce mécanisme évite, dans certaines situations, de signaler explicitement chaque nouvelle règle de classification montante. Il ne dispense toutefois pas le réseau de configurer les flux QoS et les ressources nécessaires à leur traitement.

Cette approche peut éviter de signaler explicitement au terminal chaque nouvelle règle montante.
6. Pourquoi la 5G se distingue-t-elle de la connexion PDN en 4G ?

En 4G, une connexion PDN fournit au terminal une connectivité vers un réseau identifié par un APN. Elle est associée à un default EPS bearer et peut comporter plusieurs dedicated EPS bearers.

Lorsqu’un service nécessite un traitement QoS distinct, le réseau peut établir un dedicated bearer. Dans l’architecture EPC classique, cela implique une procédure de contrôle traversant le P-GW, le S-GW, le MME et le réseau d’accès, avec une configuration correspondante du terminal.

En 5G, le QoS flow devient l’unité de différenciation QoS. Il n’est plus nécessaire d’établir un bearer de bout en bout distinct pour chaque traitement QoS.

Aspect 4G EPC 5G Core
Connectivité Connexion PDN Session PDU
Réseau de données APN DNN
Différenciation QoS EPS bearer QoS flow
Identification QoS EBI et QCI QFI et 5QI
Traitement par défaut Default EPS bearer QoS flow associé à la règle par défaut
Traitement supplémentaire Dedicated bearer si nécessaire QoS flow supplémentaire si nécessaire
Ressources radio E-RAB associé au bearer Mapping QoS flows vers DRB par le gNB
Contrôle de session MME, S-GW, P-GW SMF, avec AMF pour le relais et l’accès

La 5G dissocie également l’enregistrement du terminal et l’établissement des sessions PDU. À la différence de l’attachement EPS classique, la procédure de Registration 5G n’impose pas l’établissement d’une session PDU.

Cette distinction doit néanmoins être nuancée : des optimisations CIoT ont également introduit en 4G la possibilité de s’attacher sans connexion PDN.

6.1. Comparaison sur un scénario identique

Prenons une application qui commence à transmettre un flux vidéo nécessitant un traitement QoS distinct, alors que le terminal possède déjà une connectivité Internet.

4G Connexion PDN existante

Nouveau dedicated bearer
Signalisation EPC, NAS et radio
Ressources du bearer

5G Session PDU existante

Nouveau QoS flow si nécessaire
Modification des règles et profils nécessaires
Réutilisation possible du DRB et du tunnel N3

Le gain potentiel réside dans une plus grande indépendance entre les règles de classification, les QoS flows et les ressources de transport. Il ne faut pas en déduire qu’une modification QoS en 5G est systématiquement dépourvue de messages NAS, N2 ou N4.

7. Conclusion

Le passage de la connexion PDN 4G à la session PDU 5G ne constitue pas un simple changement de terminologie. Il introduit une organisation plus souple de la connectivité et de la qualité de service.

Les règles URSP permettent d’orienter le trafic applicatif vers une session appropriée. Les règles PCC et QoS déterminent ensuite le traitement des différents flux. Enfin, la séparation entre QoS flows, tunnels du cœur de réseau et ressources radio permet de faire évoluer le traitement des applications sans reconstruire systématiquement l’ensemble de leur connectivité.

La distinction essentielle est donc la suivante : une nouvelle application ne signifie pas une nouvelle session PDU, et un nouveau besoin QoS ne signifie pas nécessairement un nouveau QoS flow ou un nouveau DRB.

C’est cette indépendance entre connectivité, classification du trafic et ressources de transport qui permet à la 5G de répondre à des besoins applicatifs variés.

Références normatives

Les principales spécifications à citer dans l’article sont :

  • 3GPP TS 23.501 : architecture du 5GS, modèle QoS (§5.7), sélection des fonctions et modes SSC.
  • 3GPP TS 23.502, §4.3.2.2.1 : procédure d’établissement d’une session PDU demandée par le terminal.
  • 3GPP TS 23.503 : politiques PCC et règles URSP.
  • 3GPP TS 23.401 : connexion PDN et EPS bearers en 4G.

NAE Network Automation Enabler : mécanismes d’automatisation et d’intelligence artificielle intégrés au cœur du réseau 5G

La fonction NWDAF et les évolution pour l’automatisation intelligente du cœur de réseau

Introduction : vers un réseau qui se pilote lui-même

Cet article présente un ensemble de mécanismes et fonctions (NAE) que le 3GPP a standardisé pour permettre l’automatisation et l’intelligence du réseau 5G.

L’objectif est de permettre au réseau de :

  • détecter, en temps réel, qu’une zone est surchargée,
  • prédire les comportements anormaux d’équipements compromis,
  • ajuster automatiquement la qualité de service d’un flux vidéo selon les conditions radio du moment

sans intervention humaine

Cet article présente l’évolution de cette architecture d’automatisation, telle que décrite dans la publication Highlights du 3GPP (décembre 2024), rédigée par les responsables du groupe de travail CT3 (Core Network and Terminals, Working Group 3). Nous couvrirons l’évolution de la Release 15 à la Release 19, en explicitant les concepts clés.

Figure 1 : Évolution de l’architecture d’automatisation des réseaux et définition des cas d’utilisation typiques [1]

1. Pourquoi automatiser le réseau 5G ?

La 5G est conçue pour supporter une diversité de scénarios dont les KPI sont différents : communications ultra-fiables à faible latence (URLLC), connexions massives d’objets connectés (mMTC), et débits très élevés pour le grand public (eMBB). Cette diversité implique un volume de données d’exploitation et de supervision considérable, que les opérateurs ne peuvent plus gérer manuellement pour respecter les accords SLA.

L’enjeu est triple :

  • Optimiser l’expérience utilisateur en temps réel (qualité de service perçue, MOS — Mean Opinion Score)
  • Améliorer l’efficacité des ressources réseau (charge des fonctions réseau, sélection des nœuds les moins chargés)
  • Détecter et prévenir les comportements anormaux (UE compromis, attaques, anomalies de signalisation)

C’est pour répondre à ces besoins que le 3GPP a introduit, dès la Release 15, une fonction dédiée à l’analyse des données réseau : la NWDAF.

2. La NWDAF : le cerveau analytique du cœur 5G

2.1 Principe général

La NWDAF (Network Data Analytics Function) est une fonction du cœur de réseau 5G (5GC) spécifiée dans TS 29.520. Elle joue le rôle d’un moteur d’analytiques centralisé : elle collecte des données provenant de multiples sources, les traite, et fournit des informations analytiques aux autres fonctions réseau qui en ont besoin pour prendre leurs décisions.

La NWDAF s’inscrit dans l’architecture orientée services (SBA — Service-Based Architecture) propre à la 5G : elle expose ses services via des interfaces HTTP/2 standardisées, exactement comme l’AMF, le SMF ou le PCF.

2.2 Fonctionnement : collecte, traitement, analytiques

Le cycle de fonctionnement de la NWDAF suit trois étapes :

  1. Collecte de données : la NWDAF récupère des données auprès de diverses sources — les fonctions réseau du cœur (NFs : AMF, SMF, UPF…), les fonctions applicatives (AF), et les systèmes d’exploitation et maintenance (OAM). Elle peut aussi collecter des métriques de performance radio (débit montant/descendant depuis l’OAM RAN) et des données de qualité d’expérience (QoE) depuis les fonctions applicatives.
  2. Traitement et modélisation : la NWDAF traite les données brutes, applique des algorithmes statistiques ou d’apprentissage automatique (ML), et produit des informations analytiques structurées.
  3. Exposition des analytiques : les consommateurs (PCF pour les politiques, NSSF pour la sélection de tranche réseau, AMF pour la mobilité…) souscrivent aux analytiques pertinentes et les utilisent pour leurs décisions.

Les analytiques produites peuvent être de deux natures :

  • Statistiques : description d’événements passés (que s’est-il passé ?)
  • Prédictives : anticipation d’événements futurs (que va-t-il se passer ?)

3. L’évolution release par release : de Rel-15 à Rel-19

Release 15 (2019) — La fondation

La NWDAF est introduite dans sa forme initiale. Elle est capable de collecter des données réseau et de produire des analytiques élémentaires. C’est une architecture monolithique : une seule entité logique gère à la fois la collecte, le traitement et l’exposition des résultats.

Cas d’usage type : analytiques de charge des tranches réseau (network slice load level), utilisées par le PCF pour affiner ses décisions de politique QoS, ou par le NSSF pour orienter la sélection de tranche.

Release 16 (2020) — Élargissement des sources de données

Le 3GPP étend les sources de données accessibles par la NWDAF : désormais, elle peut interroger n’importe quelle NF du cœur 5G, les fonctions applicatives (AF), et les systèmes OAM. Cette extension permet de couvrir des scénarios plus complexes.

Cas d’usage ajouté : détection de comportements anormaux des équipements utilisateurs (UE). Par exemple, la NWDAF peut détecter un phénomène de ping-pong handover (un UE oscillant entre deux cellules), ou identifier un UE compromis (piraté) et déclencher des mesures de protection — blocage des communications ou alerte — en quasi-temps-réel.

Release 17 (2022) — Décomposition fonctionnelle et nouvelles fonctions d’infrastructure

C’est la release charnière pour la maturité de l’architecture d’automatisation. Deux évolutions majeures :

a) Décomposition de la NWDAF en deux fonctions logiques :

  • MTLF (Model Training Logical Function) : chargée d’entraîner les modèles d’apprentissage automatique (ML). Elle expose des services d’entraînement aux consommateurs.
  • AnLF (Analytics Logical Function) : chargée de l’inférence, c’est-à-dire d’utiliser les modèles entraînés pour dériver des analytiques et les exposer aux consommateurs.

Cette séparation est importante : elle permet de spécialiser les ressources de calcul (les phases d’entraînement ML sont très gourmandes en ressources, différentes des phases d’inférence en production), et d’organiser la chaîne ML de façon modulaire.

b) Nouvelles fonctions d’infrastructure d’automatisation :

Fonction Spécification Rôle
DCCF (Data Collection Coordination Function) TS 29.574 Coordonne et optimise la collecte de données entre les sources et les consommateurs d’analytiques, évitant les collectes redondantes
MFAF (Messaging Framework Adaptor Function) TS 29.576 Adaptateur de framework de messagerie, facilitant la distribution des données entre fonctions via des mécanismes de publish/subscribe
ADRF (Analytics Data Repository Function) TS 29.575 Stockage persistant des données analytiques, permettant de les réutiliser sans recollecte

Ces trois fonctions renforcent l’efficacité de toute la chaîne : collecte moins redondante, distribution plus flexible, réutilisation des données.

Figure 2 : Architecture NAE

Release 18 (2024) — Intelligence augmentée et apprentissage fédéré

La Release 18 (première release de la 5G-Advanced) apporte plusieurs enrichissements substantiels :

Analytiques pour la description des flux applicatifs (PFD Determination) : la NWDAF peut analyser le trafic du plan utilisateur et les descriptions de flux de paquets (PFD — Packet Flow Description) pour en déduire de nouvelles PFDs, permettant une classification applicative plus fine et dynamique.

Métriques de précision des modèles ML : la NWDAF peut désormais calculer et exposer des indicateurs de fiabilité de ses modèles ML et de ses analytiques. Cela permet aux consommateurs d’évaluer la confiance accordée à une prédiction avant de l’utiliser pour une décision critique.

Apprentissage fédéré (Federated Learning) : plusieurs instances NWDAF (déployées dans différents domaines réseau, ou chez différents partenaires) peuvent entraîner collaborativement un modèle ML sans partager leurs données brutes locales. Chaque instance entraîne localement et ne partage que les mises à jour de modèle (les gradients ou poids). C’est une approche préservant la confidentialité des données, particulièrement utile dans des scénarios d’itinérance (roaming) ou de fédération d’opérateurs.

Analytiques en situation d’itinérance : la gestion des analytiques et des échanges de données en contexte roaming est formalisée, permettant à un opérateur visité de bénéficier de l’intelligence analytique de l’opérateur domicile.

Release 19 (en cours) — Vers l’IA au service des cas d’usage verticaux

La Release 19, activement développée par le groupe CT3 au moment de la publication de cet article, étend encore les capacités vers de nouveaux cas d’usage :

  • Amélioration du positionnement assistée par IA : la NWDAF peut contribuer à l’amélioration de la précision de localisation des UEs en exploitant des données analytiques complémentaires aux techniques radio classiques (TDOA, AoA…).
  • Apprentissage fédéré vertical : extension du Federated Learning à des scénarios impliquant des acteurs verticaux (industrie, santé, transport) au-delà des seuls opérateurs.
  • Recommandation de politique QoS : la NWDAF peut suggérer proactivement au PCF des ajustements de politique QoS basés sur ses prédictions d’usage et d’expérience.
  • Atténuation et prévention de comportements anormaux réseau : évolution des mécanismes de détection vers une posture plus proactive, avec des actions préventives automatisées.

4. Cas d’usage illustratifs

Cas 1 : L’expérience de service (MOS)

Un opérateur souhaite mesurer en continu la qualité perçue (Mean Opinion Score) d’un service de streaming vidéo sur ses tranches réseau. La NWDAF collecte les métriques QoE depuis la fonction applicative (délai moyen de paquets, taux de perte, débit), les données de flux QoS depuis les NFs du cœur, et les métriques radio (débit RAN) depuis l’OAM. Elle produit des analytiques à différentes granularités : par UE individuel, par groupe d’UEs, par application, par type d’accès, par tranche réseau. L’opérateur identifie ainsi les goulots d’étranglement et les opportunités d’optimisation réseau ciblées.

Cas 2 : Analytiques de charge des fonctions réseau (NF Load)

Un AMF doit sélectionner un SMF pour gérer une nouvelle session PDU. Plutôt que de choisir au hasard parmi les SMFs disponibles, l’AMF interroge la NWDAF pour connaître la charge actuelle et prévisionnelle de chaque SMF (usage CPU virtuel, mémoire, disque, charge de trafic). La NWDAF collecte ces informations auprès du NRF (registre des NFs) et de l’OAM, et produit un résultat structuré incluant le statut, la charge courante et la charge de pointe de chaque SMF. L’AMF sélectionne ainsi le SMF le moins sollicité, améliorant l’efficacité globale du réseau. Le même principe s’applique à la sélection de l’UPF par le SMF.

5. Points clés à retenir

L’architecture NAE illustre une tendance de fond dans la normalisation 5G : l’intégration native de l’intelligence artificielle et de l’apprentissage automatique dans les protocoles cœur, et non plus comme une surcouche externe. Quelques points structurants :

  • La NWDAF est une NF standardisée du 5GC, pas un produit propriétaire ni une surcouche OAM. Elle s’intègre via les mêmes interfaces SBI (HTTP/2) que toutes les NFs.
  • La décomposition MTLF/AnLF (Rel-17) est une architecture ML-native : séparation entraînement/inférence pour permettre flexibilité et spécialisation des ressources.
  • L’apprentissage fédéré (Rel-18) répond à des contraintes de souveraineté et de confidentialité des données, particulièrement importantes dans les contextes multi-opérateurs et multi-domaines.
  • L’évolution de Rel-15 à Rel-19 suit une progression cohérente : collecte → enrichissement des sources → décomposition ML → qualité des modèles → apprentissage distribué → cas d’usage verticaux.


Références normatives

  • TS 29.520 — 5G System; Network Data Analytics Services; Stage 3 (NWDAF)
  • TS 29.574 — 5G System; Data Collection Coordination Services; Stage 3 (DCCF)
  • TS 29.575 — 5G System; Analytics Data Repository Services; Stage 3 (ADRF)
  • TS 29.576 — 5G System; Messaging Framework Adaptor Services; Stage 3 (MFAF)
  • TS 23.501 — System Architecture for the 5G System (architecture SBA globale)
  • TS 23.288 — Architecture enhancements for 5G System to support network data analytics services (stage 2 NWDAF)

Source principale :

[1] 3GPP Highlights Issue 09 (décembre 2024) — « Network Automation Enablers in 5GS », Yali Yan (CT3 Chair), Zhenning Huang (China Mobile), Xuefei Zhang (Huawei). https://www.3gpp.org/technologies/nae-5gs-ct3


La vision de la 6G par SK Telecom

Vers la 6G : quelles évolutions pour l’architecture des réseaux mobiles ?

Même si les déploiements de 5G-Advanced se poursuivent, les experts 3GPP travaillent maintenant sur les études de la 6G (Rel 20) dont la commercialisation est généralement projetée après 2032.

En France, le hub collaboratif France6G a pour objectif de cartographier les acteurs de la 6G et de définir les orientations scientifiques et les verrous techniques à lever.

Les grands équipementiers et opérateurs publient régulièrement des feuilles de route qui, sans constituer des normes, dessinent un consensus assez net sur la direction que devrait prendre l’architecture des réseaux mobiles dans la prochaine décennie.

Cet article propose une synthèse pédagogique de ces grandes tendances, en s’appuyant notamment sur l’une des feuilles de route les plus complètes publiées récemment, « ATHENA », le troisième livre blanc 6G de l’opérateur sud-coréen SK Telecom, publié le 23 février 2026, disponible en ligne.

Il faut garder à l’esprit que ce type de document relève de la vision industrielle, pas du standard : il ne s’agit ni d’une spécification 3GPP, ni d’une architecture normalisée par l’O-RAN Alliance, mais d’une prospective qui dialogue avec les travaux de standardisation en cours sans s’y substituer. C’est néanmoins une lecture précieuse pour comprendre vers quoi convergent les opérateurs, et pour anticiper les sujets qui structureront vraisemblablement les prochaines releases 3GPP et les futurs travaux de l’O-RAN Alliance.

1. Quatre ruptures attendues à l’horizon 2030

Les feuilles de route 6G s’accordent généralement sur quatre évolutions majeures de l’environnement réseau de la décennie à venir.

La première est la convergence entre intelligence artificielle et réseaux, souvent résumée par le slogan « AI Everywhere ». Elle se décompose en deux axes complémentaires : AI for Network, c’est-à-dire l’IA mise au service de l’amélioration des performances réseau, et Network for AI, c’est-à-dire le réseau repensé pour porter et accélérer la diffusion des services d’IA eux-mêmes.

La deuxième rupture est l’essor massif de nouveaux usages : généralisation des véhicules autonomes et de la réalité augmentée/virtuelle multimodale héritées de la 5G, mais aussi émergence de l’« IA physique », incarnée notamment par les robots humanoïdes, identifiée comme un relais de croissance majeur du trafic mobile de la 6G.

La troisième rupture concerne l’architecture système elle-même : diversification des services, virtualisation et ouverture des réseaux, et renforcement des exigences de protection des données personnelles imposent une refonte structurelle plutôt qu’un simple empilement de nouvelles fonctions.

La quatrième, enfin, est davantage organisationnelle : les évolutions démographiques et sociétales (pénurie de compétences techniques, vieillissement des effectifs d’exploitation réseau) imposent de revoir les paradigmes d’exploitation, d’où l’insistance des opérateurs sur l’automatisation poussée et l’autonomie des réseaux.

2. Les objectifs qui guident cette évolution

Les feuilles de route 6G articulent généralement trois objectifs : l’efficacité opérationnelle (réduction du coût total de possession, gains de productivité), l’expérience client (amélioration perçue de la qualité de service, stabilité opérationnelle) et la monétisation (nouveaux modèles d’affaires liés à l’IA, augmentation du revenu moyen par utilisateur). L’enjeu pour les opérateurs est de trouver la zone d’intersection où une même brique technologique sert simultanément ces trois objectifs, plutôt que de les traiter séparément.

3. Les briques technologiques structurantes de la 6G

En croisant les feuilles de route publiées par plusieurs grands acteurs du secteur, six familles de technologies reviennent systématiquement comme structurantes pour la 6G.

L’IA d’abord : intelligence cognitive, AI-RAN, IA native au réseau, autonomie complète, efficacité énergétique pilotée par apprentissage automatique.

Le cloud ensuite : virtualisation poussée, RAN entièrement « cloudifié », infrastructure extensible à la demande, sobriété énergétique.

L’ouverture : interfaces ouvertes type Open RAN, exposition d’API réseau, plateformisation des actifs de l’opérateur.

La connectivité : intégration satellite-terrestre, continuité de service, hyperconnectivité, réseaux sensibles au temps (time-sensitive networking).

La sécurité : architecture Zero Trust, résilience, détection cognitive des menaces.

Et enfin la convergence des générations et des services : cohabitation 4G/5G/6G sur une même infrastructure, diversité croissante des terminaux, multiplication des services immersifs.

4. Six grandes visions pour le réseau 6G

Ces six familles de technologies se projettent à leur tour sur six visions d’architecture qui reviennent, sous des formulations proches, dans la plupart des feuilles de route 6G actuelles.

Le réseau AI-native est un réseau qui intègre nativement l’intelligence artificielle dans ses principes de fonctionnement, selon les deux axes déjà cités AI for network et Network for AI. Côté AI for network, l’objectif est un réseau pleinement intelligent, capable d’auto-optimisation en temps réel et d’automatisation de bout en bout (exploitation, optimisation de performance, prédiction et résolution d’incidents), avec une intervention humaine réduite au minimum. Côté Network for AI, il s’agit de concevoir une infrastructure télécom à faible latence et haute performance capable d’héberger elle-même des charges de travail d’IA, le même matériel pouvant servir à la fois la communication et le calcul IA. L’infrastructure IA (XPU : GPU, DPU, NPU) n’est pas discutée dans cet article.

Le réseau cloud-native correspond à l’extension de la virtualisation à l’ensemble du réseau télécom, afin de pouvoir étendre, réduire et redistribuer dynamiquement les ressources selon les profils de trafic, avec un pilotage de bout en bout sur tous les domaines (accès radio, cœur, transport, couche service).

Le réseau ubiquitaire vise une infrastructure « agnostique à la génération », c’est-à-dire non figée sur la 5G ou la 6G, capable de faire coexister organiquement les générations technologiques et d’offrir une couverture continue, y compris via les réseaux non terrestres (NTN).

Le réseau ouvert est un écosystème non captif d’un fournisseur unique, fondé sur du matériel COTS (Commercial Off-The-Shelf) et des interfaces ouvertes, qui doit aussi permettre d’exposer les données et actifs du réseau à des tiers, dans une logique de Network as a Platform.

Le réseau Zero Trust ne fait confiance par défaut à aucune entité et vérifie en continu chaque connexion, selon le principe « trust nothing, verify everything ». Cette vision se décline en réalité de façon transversale dans chacune des autres : détection automatique d’anomalies et ajustement dynamique des politiques dans le réseau AI-native, contrôle d’accès fin par micro-service et conteneur dans le réseau cloud-native, authentification et surveillance temps réel des API dans le réseau ouvert.

Le réseau orienté client enfin est pensé prioritairement autour de l’expérience utilisateur plutôt que de la commodité opérationnelle de l’exploitant, avec un objectif de taux de panne proche de zéro et une attention particulière portée aux nouveaux types de terminaux attendus en 6G (robots humanoïdes, véhicules autonomes, lunettes AR).

5. Le RAN devient un nœud de calcul intelligent

Au niveau de l’accès radio, la 6G est généralement envisagée selon deux axes complémentaires : l’IA au service de l’optimisation radio (AI for RAN) et le RAN comme infrastructure de calcul IA (RAN for AI). Cinq exigences de conception en découlent.

L’intégration de l’IA suppose un matériel générique doté de processeurs spécialisés (GPU, NPU…) capable de traiter en parallèle, sur les mêmes ressources virtualisées, le trafic de communication et des charges de calcul IA. Cette capacité de calcul sert à la fois à optimiser intelligemment le traitement du signal aux couches hautes et à la couche physique (adaptation de lien, interface air native-IA, économie d’énergie pilotée par prédiction de trafic), et à héberger des services d’IA tiers directement en périphérie, à faible latence, ce qui ouvre la voie à de nouveaux modèles économiques.

L’automatisation et l’optimisation reposent sur un contrôleur intelligent du RAN (un RIC, au sens où l’entend l’O-RAN Alliance), qui collecte et analyse en temps réel les données réseau pour réaliser, via des agents IA, une auto-optimisation fondée sur l’intention : équilibrage de charge, optimisation de couverture, réglage de paramètres, économies d’énergie, sans intervention directe de l’exploitant. Chaque solution exécutée dans ce contrôleur prend la forme d’une application fondée sur des interfaces ouvertes — on retrouve ici le concept de rApp et de xApp tel que défini par l’O-RAN Alliance. Deux cas d’usage illustrent bien cette logique : l’optimisation de paramètres assistée par IA, où un modèle entraîné sur les données réseau propose le meilleur jeu de paramètres par cellule sous contrainte de taux de coupure, et la mise en veille MIMO assistée par IA, où le modèle décide cellule par cellule des fenêtres de sommeil/réveil sans dégrader la qualité perçue.

La virtualisation vise à découpler complètement matériel et logiciel pour permettre un redéploiement flexible des composants RAN, avec des techniques de mutualisation de ressources (resource pooling) telles que le scale-in en cas de faible charge ou le scale-up/cell pooling en cas de pic de trafic, et la capacité à faire cohabiter 4G, 5G et 6G sur une même plateforme matérielle.

L’ouverture des interfaces s’appuie sur les standards de l’O-RAN Alliance, créée en 2018, pour permettre l’interopérabilité d’équipements multi-fournisseurs aussi bien entre équipements (interfaces externes) qu’au sein même d’un équipement (interfaces internes). L’objectif est de sécuriser des données réseau et terminal de haute qualité, granulaires et normalisées, exposées ensuite vers le NWDAF, l’OSS de l’opérateur, ou des tiers pour de l’analyse ou de l’entraînement de modèles IA.

L’architecture Zero Trust, enfin, devient un principe transversal au RAN : authentification mutuelle continue et chiffrement du trafic entre fonctions internes et entre équipements, surveillance continue des attaques avec automatisation des politiques de sécurité, isolement des ressources et des charges de travail pour limiter la propagation d’une intrusion en environnement virtualisé, et arbitrage explicite entre sécurité et performance pour les services sensibles à la latence (XR, contrôle industriel temps réel, V2X) déployés en périphérie.

6. Le cœur de réseau vers l’autonomie complète

Le cœur de réseau de la 6G est généralement envisagé au-delà de la simple connectivité (« Beyond Connectivity ») : il intégrerait nativement IA, capacité de calcul et sécurité Zero Trust, avec une structure de protocoles simplifiée entre terminaux et réseau et une communication inter-fonctions nettement plus efficace que dans le cœur 5G actuel.

Cinq leviers reviennent fréquemment dans les feuilles de route pour atteindre ce but : un pilotage fondé sur l’intention (intend based), où l’opérateur ne fixe que des objectifs (latence, disponibilité, coûts) et les agents IA traduisent ensuite en plans d’action par domaine ; une coopération entre agents spécialisés (supervision, diagnostic, qualité, sécurité) capable d’orchestrer des scénarios complexes ; une boucle fermée fiable s’appuyant sur un jumeau numérique réseau pour pré-valider les modifications avant déploiement, combinée à des stratégies de déploiement progressif (Canary Update, Rolling Upgrade) ; une analyse de cause racine systématisée croisant journaux, métriques et politiques ; et l’exposition de capacités réseau (QoS, sécurité, localisation, événements) sous forme d’API ouvertes monétisables, dans une logique de Network as a Platform.

Sur le plan de la transformation cloud-native, l’objectif est un environnement de fonctions réseau entièrement cloud-native, fondé sur une architecture en microservices portable entre clouds multiples ou hybrides. L’IA y joue un rôle de résilience marquant : détection des signes avant-coureurs de panne, isolement et récupération automatique de la fonction défaillante sans intervention humaine ni interruption perçue par le client — l’idée d’un cœur de réseau « qui ne meurt pas, même quand il meurt » —, l’horizon visé étant celui des réseaux dits « de niveau 4 » d’autonomie.

Côté ouverture de services, on distingue généralement trois niveaux de maturité pour l’exposition réseau : l’appel API simple, l’exposition contextuelle (qui tient compte de la situation de l’utilisateur) et l’exposition fondée sur l’intention (où le réseau traduit lui-même l’intention de service en politiques). S’y ajoutent des services d’itinérance en périphérie (Roaming Edge), avec des fonctions de plan utilisateur déployées dans le cloud à l’étranger mais pilotables depuis le réseau d’origine, pour rapprocher le traitement des données des clients en itinérance.

L’architecture Zero Trust appliquée au cœur insiste particulièrement sur la fonction d’exposition réseau et la passerelle API, identifiées comme points de vulnérabilité majeurs où se croisent menaces externes et internes : vérification continue de chaque appel API (origine, validité du certificat, intégrité du message, expiration du jeton), principe de moindre privilège granularisé jusqu’au niveau de l’endpoint, chiffrement systématique des échanges (IPSec, TLS récents), et gouvernance de sécurité intégrant sécurité de la chaîne logicielle d’approvisionnement et micro-segmentation.

7. Le réseau de transport, moteur discret de la performance 6G

Le réseau de transport est hors-scope de la 3GPP, alors qu’il conditionne directement la latence et la capacité de bout en bout. Plusieurs évolutions s’y dessinent.

Le pilotage de bout en bout assisté par IA repose sur un orchestrateur combinant un module de collecte de données, un cadre d’inférence IA (gestion des modèles, exécution de l’inférence, optimisation de performance) et un cadre d’automatisation qui agit en temps réel sur le réseau à partir des résultats d’analyse — avec, à la clé, un temps de détection et de résolution d’incident pouvant être ramené à l’ordre de la seconde sur des réseaux comptant plusieurs milliers de routeurs.

L’évolution vers des réseaux tout-optiques convergés vise à s’affranchir de la dépendance aux équipementiers en migrant vers des équipements convergés couches 1 à 3, une architecture de fronthaul nouvelle génération combinant fibre optique transparente et PON, et des architectures « White Box » à bas coût pour le matériel d’accès optique. Le pilotage de cet ensemble multi-fournisseurs s’appuie sur un modèle de données de gestion commun et des API ouvertes, notamment pour piloter les multiplexeurs optiques reconfigurables nouvelle génération (NG-ROADM), capables de débits supérieurs à 200 Gbit/s par longueur d’onde. La capacité par lien de fronthaul, actuellement de l’ordre de 25 Gbit/s, est en cours de migration vers 50 Gbit/s et au-delà, ce qui impose le recours à des modulations plus complexes (PAM4) et à l’optique cohérente numérique pour compenser la pénalité de dispersion liée à la montée en débit.

La sécurisation post-quantique du transport constitue l’un des chantiers les plus structurants pour la décennie à venir. Face à la menace que la maturation de l’informatique quantique fait peser sur les schémas de chiffrement classiques, les opérateurs envisagent une architecture de sécurité double : la distribution quantique de clés (QKD), qui repose sur l’installation d’équipements dédiés aux points névralgiques du réseau (centres de données, sites B2B, centraux), combinée à des algorithmes de cryptographie post-quantique (PQC) sur les liaisons de transmission. Ces services sont d’abord ciblés sur la synchronisation de données massives entre centres de données et sur des liaisons dédiées B2B dans des secteurs sensibles (finance, santé, secteur public, industrie).

Le dimensionnement du transport pour les services xPU anticipe l’arrivée massive de l’IA en répartissant les rôles entre des centres de données IA dédiés à l’entraînement de grands modèles (concentration de GPU, TPU, FPGA) et des clusters répartis en périphérie du réseau, dédiés à l’inférence en temps réel et faible latence, au plus près des usages (analyse vidéo, reconnaissance vocale, traitement de données IoT). Des essais pilotes de clustering GPU longue distance entre sites, combinant routeurs ouverts, modules optiques 400G et cartes réseau RDMA, sont déjà en cours pour évaluer les performances de transmission et d’entraînement sur des réseaux RoCE.

Enfin, le jumeau numérique du réseau de transport (Network Digital Twin) ambitionne de répliquer fidèlement, dans l’espace numérique, l’ensemble des éléments du réseau réel — structure, ressources, trafic, historique de pannes, politiques d’exploitation — afin de permettre simulation, automatisation, optimisation, prédiction et vérification avant tout changement sur le réseau de production.

8. La donnée réseau, nouvelle brique d’architecture à part entière

Un trait marquant des feuilles de route 6G les plus récentes est l’émergence d’un domaine d’architecture entièrement consacré à la valorisation de la donnée réseau, au même rang que l’accès radio, le cœur et le transport. Le constat de départ est connu des opérateurs : la donnée générée par le réseau (localisation, trafic, qualité radio…) est déjà exploitée commercialement — analyse de fréquentation en temps réel, services de positionnement, analyse de zones commerciales — mais la multiplication des cas d’usage en 6G rend intenable la construction d’un pipeline de données indépendant pour chaque service, en raison de la redondance des coûts de développement, de la complexité opérationnelle croissante et de la difficulté à maintenir des politiques de sécurité cohérentes.

Une plateforme de ce type s’organise généralement autour de quatre principes. Une architecture hybride edge-cloud combine un moteur d’exécution en périphérie, capable de fonctionner de manière autonome y compris en cas de coupure temporaire avec le cloud — un point critique pour des environnements industriels (automatisation d’usine, télémédecine) — et capable d’appliquer de l’apprentissage fédéré pour entraîner des modèles sans faire transiter de données sensibles hors du site, avec un moteur d’exécution centralisé dans le cloud responsable de la supervision globale, de la gestion des politiques (souvent via une approche Infrastructure as Code fondée sur Git) et de la conformité réglementaire (RGPD notamment).

Le développement de services pilotés par l’IA s’appuie sur le traitement automatique du langage naturel pour traduire une expression de besoin métier en attributs de données nécessaires, sur des pipelines de feature engineering automatisés, et sur la génération et le réglage automatiques de modèles candidats, orchestrés ensuite avec des mécanismes de résilience désormais classiques en architecture distribuée (circuit breaker, tentatives de relance, délais d’expiration).

L’exploitation autonome assistée par IA se matérialise par des copilotes d’exploitation combinant grand modèle de langage (LLM) et génération augmentée par récupération (RAG), s’appuyant sur une collecte d’observabilité standardisée (métriques, journaux, traces, selon le standard OpenTelemetry), des moteurs de détection d’anomalies et d’analyse de cause racine, et des bases de connaissances indexées des incidents passés pour proposer, après validation humaine, des actions correctives automatisées — avec, à terme, des mécanismes d’auto-réparation pour les pannes mineures.

Enfin, un modèle de gouvernance à deux plans distingue généralement un plan de gouvernance centralisé, qui gère les politiques de manière déclarative avec validation et déploiement automatisés via CI/CD, d’un plan de livraison en périphérie, qui packages et déploie rapidement les services conteneurisés avec des capacités de retour arrière rapide et de déploiement progressif — le tout sous une architecture Zero Trust cohérente entre edge et cloud.

9. Une vision industrielle à mettre en perspective avec la standardisation

Trois précautions de lecture s’imposent lorsqu’on exploite ce type de feuille de route à des fins pédagogiques ou de veille.

D’abord, il s’agit toujours d’une vision d’opérateur ou d’équipementier, pas d’un standard : chaque acteur y développe sa propre nomenclature de fonctions et d’architectures, qui ne préjuge en rien de ce qui sera effectivement retenu par le 3GPP ou l’O-RAN Alliance. Ces feuilles de route sont d’ailleurs souvent accompagnées d’une clause de réserve explicite rappelant qu’elles sont fournies à titre d’information et ne constituent aucun engagement sur une technologie ou un service réellement livré.

Ensuite, ces documents mêlent délibérément des registres différents : une part de prospective pure (« devrait évoluer », « est attendu ») et une part de R&D réelle, mais à des stades de maturité très variables — certains éléments déjà déployés en commercial, d’autres encore au stade de la preuve de concept ou du pilote en laboratoire. Une lecture rigoureuse impose de toujours vérifier à quel stade de maturité se situe l’élément cité avant de le présenter comme une réalité opérationnelle.

Enfin, ces visions s’inscrivent explicitement dans un dialogue avec les instances de standardisation en cours — 3GPP (notamment les travaux des Releases 19 et 20), O-RAN Alliance (SMO, RIC, interfaces O1/O2/R1), ETSI NFV, AI-RAN Alliance, GSMA — sans pour autant s’y substituer. Elles constituent à ce titre un bon point d’entrée pour suivre, dans les prochaines releases, lesquelles de ces propositions seront effectivement retenues, et lesquelles resteront propres à l’écosystème d’un opérateur donné.

10. Conclusion

Au-delà des appellations propres à chaque opérateur, un panorama assez cohérent se dégage des feuilles de route 6G publiées ces dernières années : un réseau pensé nativement pour l’IA — à la fois optimisé par elle et conçu pour l’héberger —, entièrement virtualisé et orchestré de bout en bout, ouvert à l’interopérabilité multi-fournisseurs, sécurisé selon les principes Zero Trust à chaque couche, et dont la donnée elle-même devient un domaine d’architecture à part entière. Pour qui enseigne ou pratique la veille sur les réseaux 5G-Advanced et 6G, ces documents constituent une référence utile à croiser avec les travaux de standardisation du 3GPP et de l’O-RAN Alliance qui, seuls, détermineront in fine ce qui sera réellement déployé.


Glossaire des principaux sigles

Sigle Signification
AI-RAN Artificial Intelligence – Radio Access Network
COTS Commercial Off-The-Shelf
DCO Digital Coherent Optics
LCM Life Cycle Management
NG-ROADM Next-Generation Reconfigurable Optical Add-Drop Multiplexer
NTN Non-Terrestrial Network
NWDAF Network Data Analytics Function
O-RAN Open Radio Access Network
PAM4 Pulse Amplitude Modulation 4-level
PQC Post-Quantum Cryptography
QKD Quantum Key Distribution
RIC RAN Intelligent Controller
RoCE RDMA over Converged Ethernet
SBA Service Based Architecture
vRAN Virtualized Radio Access Network
xPU terme générique pour GPU/NPU/TPU/FPGA
ZTA Zero Trust Architecture

Pour aller plus loin

SK Telecom, 2026 SK Telecom 6G White Paper – Vision on Future Network Architecture, ATHENA, 23 février 2026 : news-static.sktelecom.com/…/2026-SKT-6G-White-Paper-ATHENA_Eng.pdf

6G Progress Report, GSMA, May 2026, https://www.gsma.com/solutions-and-impact/technologies/networks/wp-content/uploads/2012/10/GSMA-6G-Progress-Report-May-2026.pdf


E2E Network Slicing : le découpage du réseau de bout en bout (Partie 2)

[bws_captcha]Cet article est la suite de :

« E2E Network Slicing : le découpage du réseau de bout en bout (Partie 1)

III) La virtualisation du cœur de réseau

Les entités du cœur de réseau AMF, SMF, NEF, PCF sont des fonctions qui peuvent être virtualisées. Ces fonctions gèrent le plan de contrôle du réseau de mobiles et les performances fonctionnelles sont analysées au niveau du support opérationnel OSS (FCAPS).

L’entité UPF peut également être virtualisée, cette fonction gère le plan utilisateur. La fonction UPF possède des capacités d’aiguillage de trafic à partir de la classification de flux UL-CL (Uplink Classifier). Ainsi, la fonction UPF peut avoir le rôle de point de branchement (multi-homing), point d’ancrage de session (PSA : PDU Session Anchor) ou classificateur de flux pour définir le prochain saut. La classification de flux est une fonctionnalité supportée par la fonction UPF afin de diriger le trafic localement en fonction des filtres appliqués au trafic UE.

Le contrôle des fonctions virtuelles dans le cœur de réseau 5G est réalisé par deux fonctions nommées NSSF (Network Slice Selection Function) et NRF (Network Repository Function).

  • Le rôle du NSSF est de sélectionner le jeu de tranches réseau que l’utilisateur va pouvoir utiliser en fonction de son contrat d’abonnement (SLA) pour lui apporter la QoE (Quality of Experience) souhaitée. Le choix du slice se faisant au moment de l’enregistrement du mobile, la fonction NSSF dialogue avec la fonction AMF ou la fonction NSSF d’un autre PLMN.
  • Le rôle du NRF est de fournir un contrôle des fonctions virtuelles (NF) et des services proposés par les fonctions virtuelles.
    • La fonction NRF est un catalogue qui est mis à jour au moment de l’activation de la fonction virtuelle (enregistrement) et mis à jour lorsque la fonction virtuelle est redimensionnée. Elle propose ainsi un service de découverte de fonctions virtuelles
    • Toute fonction virtuelle NF peut demander à la fonction NRF, par une procédure de souscription, d’être informée dès qu’une nouvelle instance est créée.

Figure 5 : Inscription d’une fonction virtuelle au niveau de la fonction NRF (TS 29.510)

Une sous-instance virtuelle est composée au minimum de fonctions AMF, SMF, PCF, NRF. L’opérateur (OSS) met en place un ou plusieurs sous réseaux virtuels SNI et peut à tout moment activer ou désactiver un sous-réseau (procédure NSI figure 3). Chaque fonction activée vient se déclarer auprès de la fonction NRF (figure 5).

Une instance de réseau permet de gérer un type de service. Le type de service est défini par la variable S-NSSAI. Le S-NSSAI contient 2 champs :

  • SST sur 8 bits défini le type de slice (Slice Service Type)
    • SST = 1 : eMBB (normalisée 3GPP) ;
    • SST = 2 : URLLC (normalisée 3GPP) ;
    • SST = 3 : mMTC (normalisée 3GPP) ;
    • SST = 4 : V2X (normalisée 3GPP) ;
    • SST= 5 : HMTC (High Performance MTC normalisée 3GPP – R.17 – mise à jour janvier 2022);
    • SST=6 : HDLLC (High Data Low Latency Communication 3GPP – R.18 mise à jour juin 2023)
    • SST= 7 : GBRSS (Garanted Bit Rate Streaming Service) pour du débit descendant garanti dans le cas de la vidéo (streaming).
    • SST de 128 à 255 sont définis par l’opérateur.
  • SD (Slice Differentiator) est une information optionnelle qui permet de décliner plusieurs types de sous-service dans une catégorie SST donnée afin de différencier les clients.

La fonction NSSF permet d’identifier les NSI. Cette fonction est configurable via une API REST.

Voici un exemple de configuration de la fonction NSSF :

https://host:port/v1/nssf/configurations/nsiprofiles
POST
Content-Type: application/json
BODY
{
    « name »: « NSI001 »,
    « nrfUri »: « https://nrf.bloglaunay.com »,
    « nsiId »: « 1 »,
    « targetAmfSets »:
    [
        {
            « regionId »: « 01 »,
            « setId »: « 001 »,
            « setFqdn »: « set001.region01.amfset.5gc.mnc111.mcc208.3gppnetwork.org »
        },
        {
            « regionId »: « 01 »,
            « setId »: « 002 »,
            « setFqdn »: « set002.region01.amfset.5gc.mnc111.mcc208.3gppnetwork.org »
        }
    ]
}

Pour être plus complet, la configuration de la fonction NSSF permet aussi de diriger le choix de la fonction NRF en fonction du NSSAI demandé.

D’un point de vue opérateur : Lorsqu’une tranche de réseau est mise en œuvre, la fonction AMF peut toujours mettre à jour la configuration S-NSSAI de la fonction NSSF afin d’informer celle-ci des types de service supportés par la fonction AMF sur une zone de localisation TA.

Une fonction AMF peut gérer plusieurs tranches de réseaux S-NSSAI (il n’y a pas de limite fixée au niveau du cœur de réseau).

Figure 6 : La mise à jour de la fonction NSSF

L’entité NSSF sélectionne le (ou les) instances de réseau NSI correspondant(s) à la demande du mobile à partir du (ou de la liste des) S-NSSAI et détermine ainsi les fonctions AMF candidates correspondant spécifiquement (ou au mieux) à la demande de l’UE. Eventuellement, l’entité NSSF interroge la base de données NRF (Network Repository Function).

Figure 7 : Procédure d’enregistrement et sélection du NSI

L’entité NSSF renvoie à la fonction AMF qui l’a interrogée, la valeur NSSAI autorisée sur la zone TA et la liste des fonctions AMF candidates (figure 7).

Lorsque la station de base s’active (mise en route ou suite à une procédure de ré-initialisation), elle interroge les fonctions AMF pour connaître les tranches de réseaux (slices) supportées par chaque fonction AMF accessible comme le montre la figure 8.


Figure 8 : La déclaration des slices supportées par les fonctions AMF auprès de l’entité gNB

Si la station de base gNB était déjà en fonctionnement, alors elle est informée des modifications NSSAI apportées au niveau de la fonction AMF via le message NG Setup request (figure 9).

Figure 9 : La mise à jour des slices supportées par les fonctions AMF auprès de l’entité gNB

Lorsque le mobile s’active, il réalise une procédure d’attachement auprès d’une fonction AMF. L’attachement se fait sur une fonction AMF parmi toutes les fonctions AMF qui ont été activées par le support opérationnel OSS et accessible par la station de base gNB.

La sélection de l’entité AMF est réalisée au moment de la procédure d’attachement. Le choix est effectué à partir de l’identifiant NSSAI émis dans la requête NAS REGISTER. La station de base gNB reçoit la requête RRC qui porte le message NAS et l’indicateur NSSAI à partir duquel il sélectionne une fonction AMF. Si plusieurs fonctions AMF candidates peuvent être choisies (cf figure 8), la station de base gNB fait son choix par équilibrage de charge.

La fonction AMF sélectionnée par l’entité gNB interroge la base de données UDM pour vérifier que l’indicateur NSSAI demandé par le terminal (requested NSSAI) est accepté. L’entité UDM transmet à la fonction AMF le NSSAI autorisé pour ce client (allowed NSSAI). A partir de ce moment, la fonction AMF consulte la fonction NSSF (Network Slicing Selection Function) à partir d’une requête GET en indiquant la liste des S-NSSAI autorisés.

Si après consultation de la fonction NSSF, la fonction AMF sélectionnée initialement (appelée AMF source) par la station de base n’est pas appropriée pour les services demandés (NSSAI), alors la fonction AMF source réalise la procédure de ré-allocation de la fonction AMF.

Concernant la ré-allocation (lors de la procédure d’attachement), deux options sont possibles :

Dans le cas de l’option A (figure 10), en fonction des informations de souscription et de politique locale, la fonction AMF source décide d’envoyer la requête initiale vers la fonction AMF cible via le message Namf_Communication_N1MessageNotify portant le message NG-RAN Reroute Message.

Cependant, comme il ne peut y avoir qu’un seul point de terminaison N2 entre l’entité gNB et la fonction AMF pour un UE donné, la fonction AMF cible met à jour le point de terminaison auprès du gNB via le message NG AMF Configuration Update.


Figure 10 : Procédure de ré-allocation de la fonction AMF pour la gestion des transches de réseau du mobile UE : Option A

Dans le cas de l’option B (figure 11), en fonction des informations de souscriptions et de politique locale, la fonction AMF source décide d’envoyer le message NGAP Reroute NAS Message à l’entité gNB afin que celle-ci formule une nouvelle requête d’attachement vers la fonction AMF cible.

Figure 11 : Procédure de ré-allocation de la fonction AMF pour la gestion des tranches de réseau du mobile UE : Option B

Au niveau du cœur de réseau, le mobile s’enregistre sur une seule fonction AMF.

Le mobile peut demander à profiter de plusieurs tranches de réseaux (figure 12), les fonctions AMF, NSSF font parties des fonctions communes à toutes les tranches. Les fonctions PCF et NRF peuvent être communes ou spécifiques à une tranche de réseau.

Pour que le mobile puisse recevoir ou émettre des données, il faut mettre en place une session PDU. La session PDU est contrôlée par la fonction SMF, avec des règles PCF spécifiques.

Figure 12 : Les tranches de réseaux : Fonctions communes et spécifiques.

Il est aussi possible d’ajouter des fonctionnalités supplémentaires comme imposer la direction de trafic (trafic steering) en sortie du réseau de mobiles Gi-LAN afin d’apporter des services comme de l’optimisation vidéo, optimisation http, un cache CDN, un cache de réalité virtuelle, un détecteur de malware, une fonction parentale, un parefeu, …

Au niveau du mobile, le mobile fait une demande d’enregistrement auprès du cœur de réseau. Le mobile indique dans sa requête NAS les tranches de réseaux souhaitées (Requested NSSAI). Le requested NSSAI correspond soit au NSSAI configuré pour le PLMN (configured NSSAI), soit au NSSAI autorisé pour le PLMN (allowed NSSAI). Ce dernier (allowed NSSAI) a été récupéré lors d’un précédent enregistrement. Si le mobile n’a aucun NSSAI configuré pour le PLMN sur lequel il s’enregistre, alors il transmet l’information NSSAI configurée par défaut (Default configured NSSAI).

L’information NSSAI est configurée sur la mémoire non volatile du mobile. Il ne revient pas au standard 3GPP d’indiquer où est stockée cette information mais aux fabricants de terminaux. Le mobile peut contenir plusieurs informations NSSAI, chaque NSSAI est couplée à l’identifiant SUPI et est identifiée par le PLMN ID (cf. TS 24.501). Si on change l’identifiant SUPI, les informations NSSAI sont supprimées de la mémoire du terminal.

Dans le cas des smartphones, l’information NSSAI est configurée par défaut (Default configured NSSAI).

Dans le cas des terminaux IoT et URLCC, l’information NSSAI devrait être provisionnée afin de limiter l’impact de charge au niveau de la fonction AMF grand public lorsque les terminaux IoT s’allumeront.

Le mobile doit stocker les informations S-NSSAI du HPLMN. Si le mobile est enregistré sur un réseau visité VPLMN, le mobile doit aussi sauvegarder le NSSAI configuré pour ce VPLMN et doit faire la correspondance avec les S-NSSAI qu’il peut exploiter sur le réseau HPLMN. Le mapped NSSAI est utilisé en roaming pour faire la correspondance entre un S-NSSAI spécifique (128 à 255) du réseau H-PLMN et le S-NSSAI correspondant dans le VPLMN.

Lorsque le mobile demande l’établissement d’une session PDU, il transmet dans le message NAS l’information S-NSSAI souhaitée et des règles URSP (UE Route Selection Policy).


Le dernier paragraphe sera traité dans un autre article.

Les tranches de réseau : Network Slicing

Cet article propose de faire une première synthèse des technologies abordées dans les articles précédents comme la virtualisation matérielle, la virtualisation des fonctions réseaux NFV, le chaînage des fonctions service (SFC) et l’approche de découpage du plan de données et du plan de contrôle (SDN).

La programmation des réseaux est une tendance émergente qui permet de transformer l’usage du réseau en s’appuyant sur des solutions logicielles. Si la virtualisation (cf  article : http://blogs.univ-poitiers.fr/f-launay/2018/01/23/virtualisation-du-reseau-epc-concept-nfvsdn/ )a permis de déployer des services réseaux facilement sous le contrôle d’un orchestrateur (cf article : http://blogs.univ-poitiers.fr/f-launay/2018/02/04/network-functions-virtualisation-nfv-pour-le-reseau-4g5g/), l’enchainement des fonctions de services (NVFFG ou SFC : article http://blogs.univ-poitiers.fr/f-launay/2018/01/28/le-sfc-service-function-chaining-mise-en-oeuvre-du-sdnnfv-sur-le-reseau-de-mobile-4g/) permet la flexibilité et l’adaptabilité du réseau en fonction de la demande.

Le chainage de fonction service s’appuie sur une approche SDN (cf article http://blogs.univ-poitiers.fr/f-launay/2018/01/15/principe-du-sdn-dans-une-architecture-reseau-classique/) pour programmer les besoins de services d’acheminements de flux et de contrôle de flux en proposant une abstraction de la couche réseau aux services applicatifs.

Grâce à ces différentes technologies (SDN, NFV, SFC), la programmation du réseau apporte une flexibilité et une modularité permettant de créer simultanément plusieurs réseaux logiques (virtual network) pilotés par la couche application via des API. Les descripteurs (NVFD) permettant de définir chaque besoin permettent ainsi de tailler un réseau à la demande et adapté au besoin (NFV MANO)

Ces différents réseaux logiques sont appelés des tranches de réseaux ou network slices et correspond à la mise en réseau de bout en bout entre un client UE et un service réseau (IoT, IP, IMS, …) en s’appuyant sur une infrastructure réseau virtuelle (SDN Overlay) ou physique (SDN). Chaque tranche de réseau est isolée des autres et gérée/contrôlée de manière indépendante (bac à sable grâce à la virtualisation et à la gestion NFV MANO) et s’adapte à la demande (easy go network).

Une tranche de réseau (network slice) est une collection de ressources, qui combinées ensemble de manière appropriées, permettent de créer un support réseau répondant aux exigences demandées. Les types de ressources pour le network slicing sont :

  • Fonction réseaux (NF : Network Function) : Bloc fonctionnel qui fournit une capacité réseau spécifique et réalise une fonction demandée. La fonction réseau est généralement une instance logicielle tournant sur une infrastructure physique mais, il peut aussi s’agir d’un équipement matériel dédie ou une combinaison des deux.
  • Infrastructure matérielle  dédiée ou partagée pouvant héberger les fonctions réseaux.

La figure 1 représente ainsi un exemple d’architecture du network slicing.

Figure 1 : L’architecture réseau en tranche

En proposant un réseau pour les différents besoins, le réseau opérateur supporte des besoins en terme de qualité de service (temps réel ou non, débit garanti ou non, bande passante, latence) très différent en fonction des besoins, comme le montre la figure 2.

Figure 2 : Approche horizontale des sous réseaux logiques de l’opérateur

I) Approche NFV

Orchestration

L’orchestration est un processus clé pour le network slicing qui s’appuie sur des descripteurs définies par exemple sur des accords de niveau de service SLA. L’orchestration est définie comme un processus de sélection optimale de ressources pour répondre entièrement aux demandes de service de chaque client. Le terme optimal réfère à l’optimisation de la politique de flux en fonction de l’abonnement du client (SLA) qui gouverne les choix du processus d’orchestration sur la sélection de ressources au niveau de l’infrastructure physique sur les POP.

Isolation

L’isolation est une exigence primordiale afin de pouvoir faire fonctionner en parallèle plusieurs tranches de réseau qui se partagent les mêmes ressources physique et les mêmes infrastructures.

L’isolation fait référence à :

  • Performance : Chaque tranche est définie par rapport à une exigence de service particulière et exprimées sous forme de KPI. L’isolation assure le respect du KPI si le service est accepté quel que soit la congestion ou les niveaux de performances des autres tranches
  • Sécurité et confidentialité : les fautes ou les attaques sur une tranche n’aura aucune incidence sur les autres tranches. De plus, chaque tranche met en œuvre ses propres fonctions de sécurités qui interdit entre autre à ce que des entités non autorisés aient un droit de lecture ou d’écriture sur la configuration d’une tranche de réseau.
  • Gestion : Chaque tranche est gérée de manière indépendante comme un réseau séparé.

II) Approche SDN

L’architecture SDN découple le plan de contrôle du plan de données permettant de configurer dynamiquement le plan d’acheminements des données comme un service à la demande du client. Cela répond aux attentes du network slicing qui a besoin de satisfaire à la demande à un large éventail de services de manière agile et à un coût optimal.

Concernant le réseau SDN, une ressource est une instance ou une entité qui peut être utilisé pour fournir un service en réponse aux demandes d’un client.  Le contrôleur est une entité centralisée qui planifie les ressources en fonction du contexte du client :

  • Contexte du client représente toutes les informations qui le contrôleur a besoin pour un client donné. Il contient :
    • un groupe de ressource : Le groupe de ressource est une vue de toutes les ressources que le contrôleur peut offrir pour répondre sur mesure à la demande du client. Le groupe de ressources est proposée par des API sur l’interface nord et correspond donc à une couche d’abstraction du réseau pour répondre au besoin du client ;
    • le support client contient les opérations et les règles de politique autorisées pour le client, ainsi que des informations relatives aux services demandés pour ajuster les actions entre la demande du client et le contrôleur.
  • Contexte serveur représente toutes les informations nécessaires au contrôleur pour interagir avec les ressources physiques accessibles via son interface sud.

Figure 3 : L’architecture SDN du network slicing